画像から動画は、簡単に見えて人を惑わせます。
1枚の画像を動かせば映像になります。しかし制作の質は、結局この問いにかかっています。
方向は商品の正しさを守れただろうか?
守れていれば、動きは証拠になります。守れなければ、動きは歪みになります。
要点
- 方向を先に固定してこそ、画像から動画は効率的になる。
- ゲートが勝者を決める:形状の正しさ、アイデンティティの安定、キャプション/オファーの整合。
- チャネルごとの書き出しバリエーションも、同じゲート論理に従う。
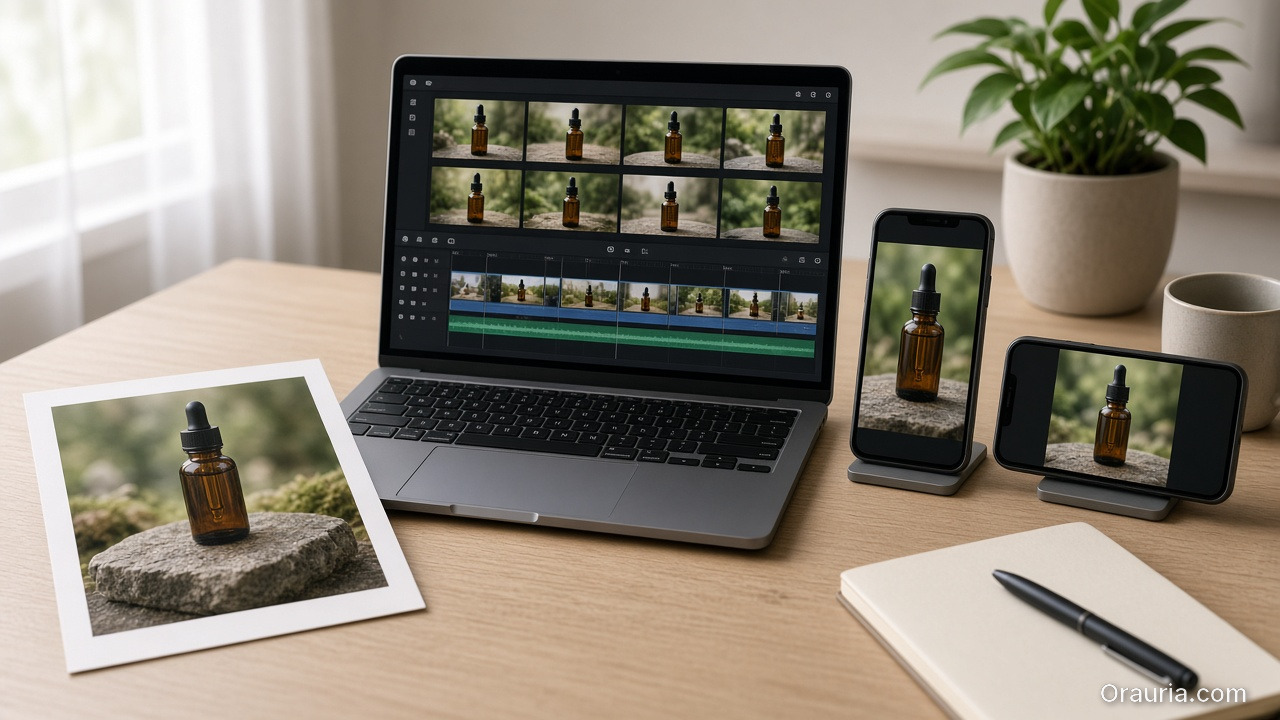
3つのワークフロー
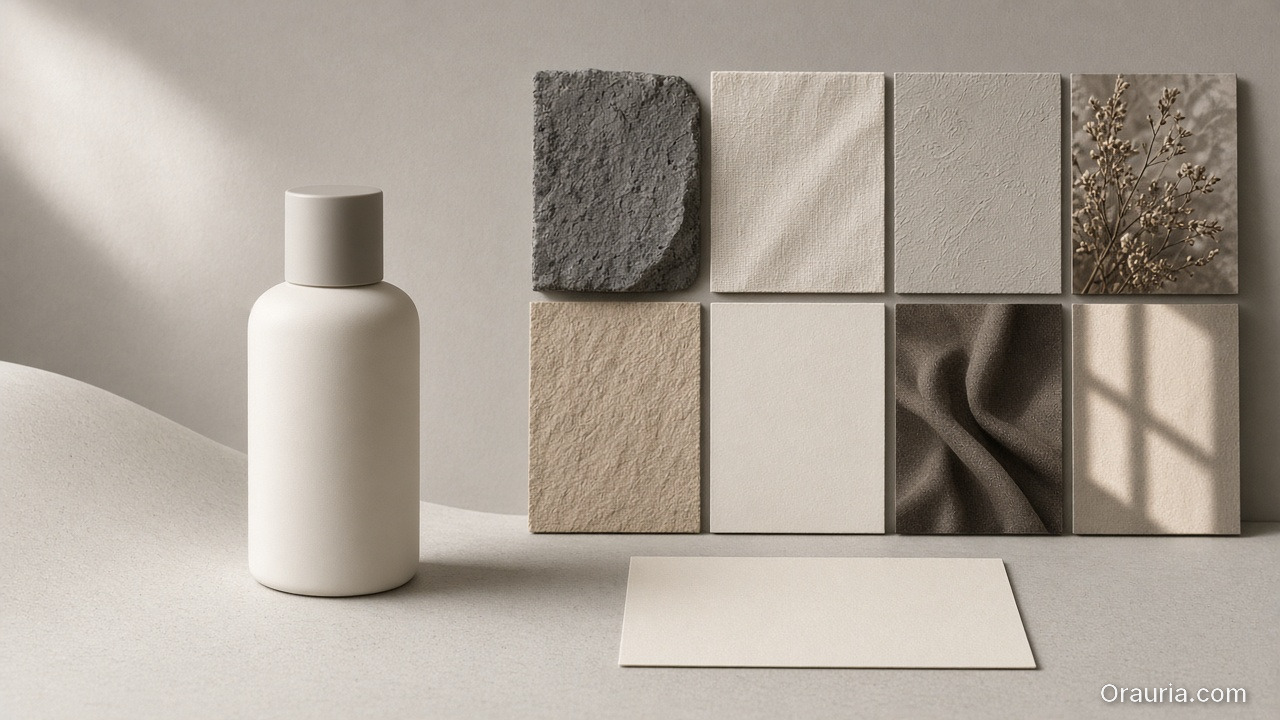
1)方向キット(真であるべきものを固定する)
先に定義します:
- 何が動くか(ポーズ/カメラの感触)、
- 何が正しく残るか(形状、ラベル可読性、アイデンティティの手がかり)、
- シーンが何を伝えるべきか(フック、証拠、オファー)。
これは「クリエイティブの方向」の層です。プロンプトを一つ足すことではありません。
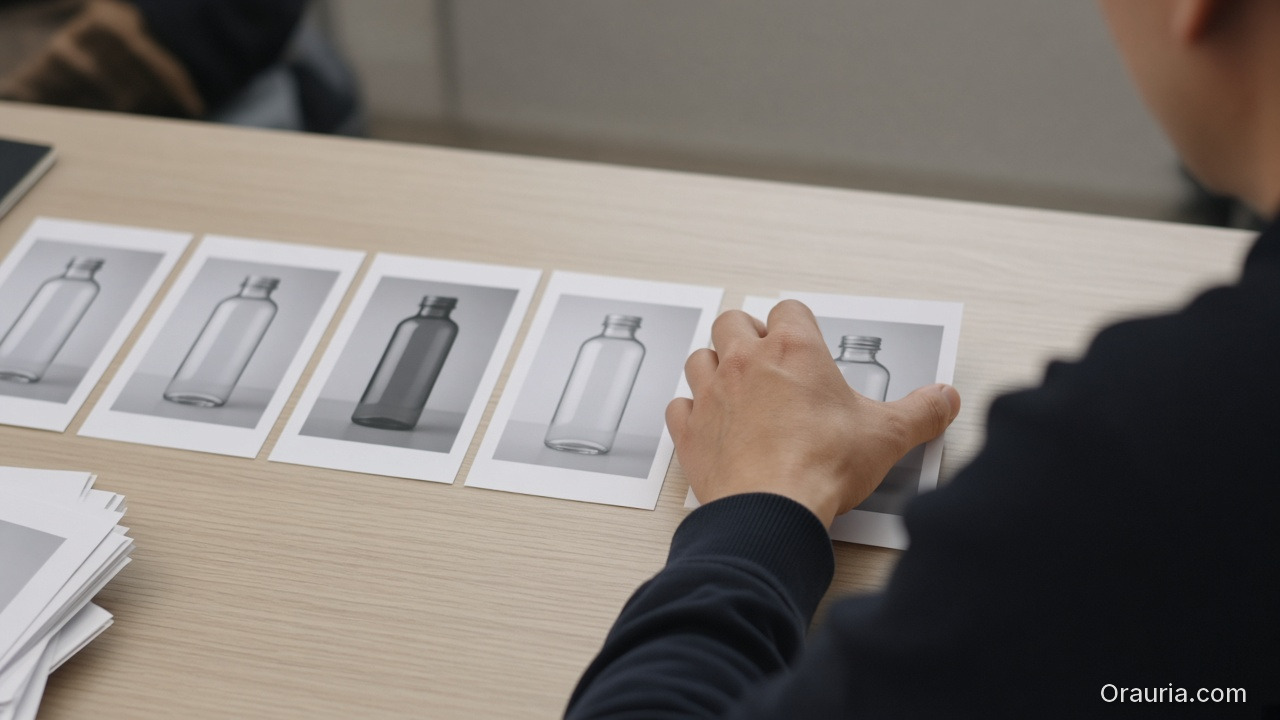
2)候補を生成する(そして速く振るい落とす)
同じ方向キットの下で複数の候補を作ります。ゲートで早く落とします:
- 縁の歪み/比率の崩れ、
- 不安定なアイデンティティの手がかり、
- リサイズ後に文字/ラベルが読めない。
すでに失敗したクリップを磨き込む時間を使わずに済みます。
3)チャネルに安全なバリエーションを書き出す(やり直しなし)
ルールに従って書き出します:
- 正しいアスペクト比、
- テキストとCTAのための安定したセーフゾーン、
- 一貫した影の系統と背景の論理。
これで出力は使い捨てのクリップではなく、再利用できるクリエイティブ資産になります。
次にやること
同じワークフローのより詳しい版は、こちらをどうぞ:
ボトルネックが「角度が足りない」なら:
Leave a Reply